周一早上八点,运营在群里问:华东这个仓下周三能出多少件?算法同事回了一个数:352 万。
这个对话每家公司都在发生。问题不在于这个数准不准,在于从它被说出口的那一刻起,就没有人知道它明天会变成什么样。下周二模型重训,数变成了 381 万。是切仓了?上游数据断了?还是模型自己抽风?没人答得上来,补货单却每天照着这个数在下。
我管这个阶段叫”一个数字的幻觉”:预测存在,预测体系不存在。这半年我做的第一件事,就是把预测从一个数字拆成一套体系。拆完再回看,那个数字本身反而是最不值钱的部分。
四层:一个数字是怎么被生产出来的
我们的预测不是一个模型直接算的,它要过四道工序:
- L1 原始融合层:几个基础模型的原始输出做融合,没人碰它。
- L2 算法策略层:算法侧选优和规则修正在这里生效,比如剔除缺货日的脏样本。
- L3 业务策略层:业务的总量预期、大促安排在这里进入。
- L4 人工调整层:计划员手工改出来的最后一版,真正拿去下单的是它。
为什么要分这么细?因为不分层的时候,预测出了错你连锅都找不到。数偏了,是模型错了,是业务预期拍错了,还是计划员改飞了?四层分开跑、分开留痕,每一层的贡献和罪过都能单独核算。这个设计后来救了我们很多次,本系列第 02 篇会讲到它在模型选择里的用处。
准确率是面子,偏差率是里子
分层之后第一个问题:哪个模型好?
直觉答案是谁准确率高谁好。我们看了几个月数据,结论挺打击人:候选池里几个模型的准确率差距常年不到 1 个百分点,今天的第一名下个月就掉回去。30 天的评估窗口里,“最准的模型”大概率只是”这 30 天运气最好的模型”,排名基本是噪声。
真正把模型区分开的是另一个指标:
偏差率 = (预测总量 − 实际总量) ÷ 实际总量
有的模型稳定偏高 5%,有的稳定偏低 6%。准确率都差不多,可一个天天让你多备货,一个天天让你缺货,对生意的影响南辕北辙。我们看板上一度同时挂着偏差率 −6.2% 到 +8.5% 的几个模型(示意数字),准确率那一栏却几乎看不出差别:
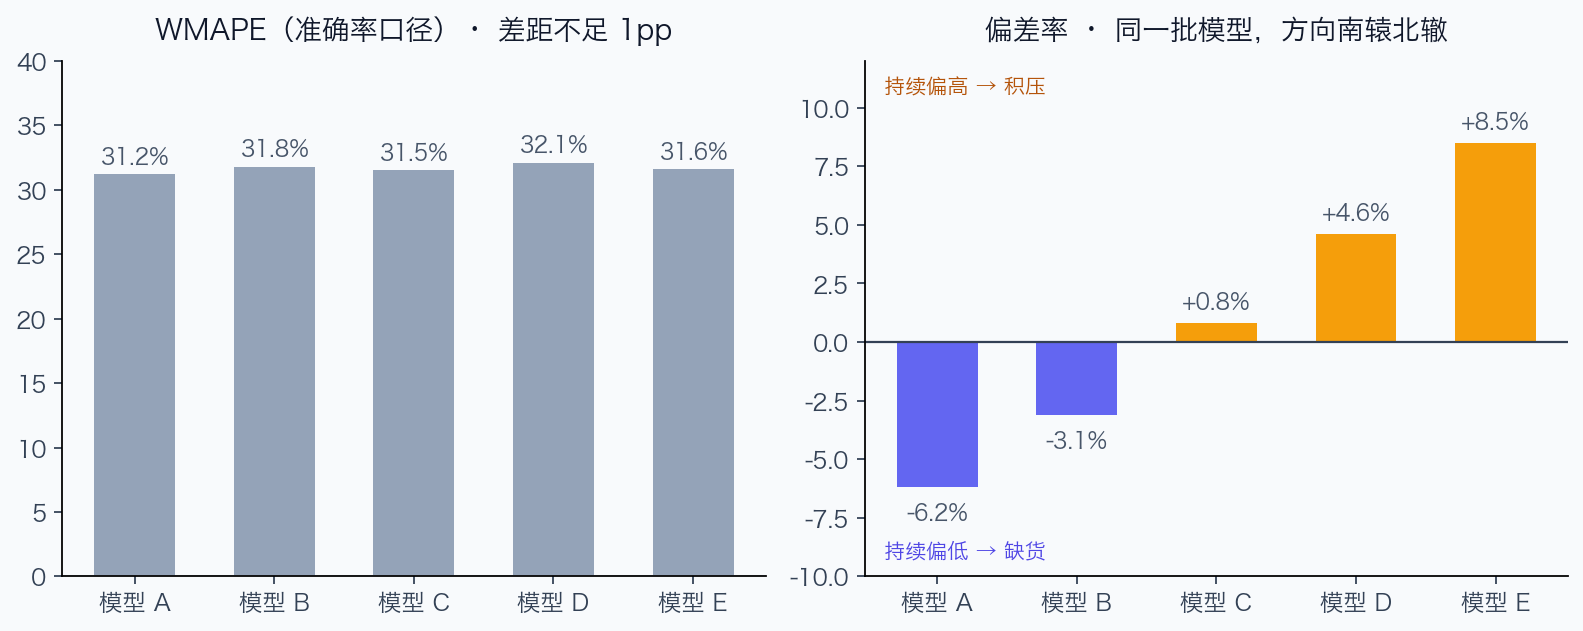
从那天起,我们内部评价模型,先问偏差,再谈准确率。
五类异常:预测会怎么死
体系化之后,我们给预测上了监控。盘下来,预测的”死法”一共五种:
- 突变。今天的运行和昨天比,同一窗口内仓级总量环比跳了 30%。多半是切仓或上游断流。
- 漂移。单日环比看不出来,拉 8 天对比,整个预测水平在缓慢爬坡或下坡。模型在悄悄劣化。
- 系统性偏差。连续三天预测对实际同方向偏离且超阈值。这个最要命,偏高了积压,偏低了缺货,补货单天天在按它执行。
- 断跑与缺失。整层没跑、预测归零、行数腰斩。检查成本最低,优先级却最高,因为下游会拿旧值甚至零值继续跑。
- 层间失真。这是分层架构独有的礼物。L1 稳如老狗而 L3 突变,问题出在业务策略层;L4 大幅偏离 L3,说明人工调整需要复核。相邻两层的差值一算,异常是哪层引入的一目了然:
层间差 = (L(n+1) − L(n)) ÷ L(n)
告警不分级,等于没有告警
监控上线第一周,群里每天几十条告警,三天后就没人看了。这个坑做告警的人几乎都踩过。我们后来把告警压成三档:
| 级别 | 含义 | 通知方式 |
|---|---|---|
| P1 | 确定性事故 | 即时推送 + @负责人 |
| P2 | 当日需关注 | 每日汇总一次 |
| P3 | 留档观察 | 只落表,不推送 |
再加两条降噪规则:同一个仓连续命中才升级;切仓窗口内的仓自动降级为留档,因为切仓期预测本来就会跳,那是业务动作,不是异常。
改完之后告警量掉了八成,处理率反而上来了。告警的价值不在于发出多少条,在于每一条都有人当真。
这套东西和 AI 进展有什么关系
这两年时序基础模型很热,TimesFM、Chronos 这一类,号称零样本就能打。我的看法可能要泼点冷水:模型会越来越好换,今年接一个基础模型,明年可能换个 Agent 来调参,但上面这套体系,一层都不会被换掉。恰恰相反,模型越强、换得越勤,你越需要一套不依赖具体模型的治理框架来回答”新模型到底好不好”。模型是流水的兵,体系才是铁打的营盘。
下一篇讲体系里最微妙的一环:当业务经验和模型输出打架,到底听谁的。答案不是二选一,而是给业务经验安排一个正确的位置。
附录:4L 分层与五类告警速查表
两个关键指标
WMAPE = Σ|预测 − 实际| ÷ Σ实际        (看准确度)
偏差率 = (Σ预测 − Σ实际) ÷ Σ实际       (看方向)
五类异常规则
| 规则 | 逻辑 | 用途 |
|---|---|---|
| A 环比突变 | 今日运行 vs 昨日运行,同窗口仓级总量 | 切仓、上游断流、重训突变 |
| B 8 日漂移 | t-8 / t-1 / t-0 三次运行同窗口日均值对比 | 渐进式劣化 |
| C 三日系统偏差 | 最近 3 个完成日预测 vs 实际,同号且均值超阈 | 积压 / 缺货风险 |
| D 断跑缺失 | 无运行 / 总量归零 / 行数较前 7 日腰斩 | 数据事故,最高优先级 |
| E 层间失真 | 相邻层同窗口总量差 | 定位异常引入层 |
降噪四条
- 同一仓 × 同一规则连续命中,第 2 天升一级,第 3 天升 P1;
- 切仓窗口内(生效前 1 天 ~ 后 3 天)的仓命中自动降级为 P3;
- 基准缺失(昨日无运行、分母为 0)标”无基准”,不产生告警;
- 命中后回到阈值内置为”已恢复”,周报体现。
规则 C 只对最终生效层(L4)告警,其余层留档——谁背准确率谁被告警,避免各层互相甩锅。
供应链实战系列 · 第 01 篇 · 卷一「预测篇」| 下篇:当业务经验和模型打架 文中数字均为 DEMO 示意,非真实业务数据。