上篇结尾,一百多个仓 × 供应商组合在回测里双改善。开会的时候有人问了个好问题:回测是拿历史数据演的,上线了是活人活货在跑,凭什么相信线上的结果会和回测一样?
诚实的回答是:没有理由直接相信,所以要实验。但库存算法做不了经典的 A/B——你不能让同一个仓的一半商品用新算法、一半用旧的,因为库存会互相挤占仓容,采购是同一个计划员在做,两组根本隔不开。我们最后用的方案,是这套方法里我最得意的部分。
找不到双胞胎,就人工配一个
思路是为每个上线仓品找一个”对照仓品”:同一个商品、在没上线算法的仓里卖,各方面尽量像。匹配规则按优先级走:
先在同省里找,近 90 天出库件数最接近的那个仓品;件数差一样,取地理距离更近的。同省找不到,就放宽到异省,取经纬度直线距离最近的;距离一样,再比件数。全省全国都没有非上线仓在卖这个商品,才标记”无自动对标”。
为什么要同省优先?因为省份是个粗糙但好用的代理变量:天气、消费偏好、物流时效、促销节奏都接近。件数接近保的是”量级可比”,量级差十倍的两个仓品,库存水位和缺货率的波动完全不是一个物种。
比匹配更重要的是:配完就锁死
这套设计里我最坚持的一条,和统计学关系不大,和人性关系很大:对标关系一旦确定,必须冻结。
实验跑了两周,如果结果不好看,总会有人提议:是不是当初对标仓选得不好?换一批试试?或者:上线日期刚好赶上促销,要不把观察窗挪一挪?
这些提议听起来都很合理,但每一次重选,都是在给”事后挑数据”开门。换对标换到结果好看为止,那不叫实验,那叫定制结论。我们的规矩是:对标关系落表、导出快照存档,之后无论结果多难看,不换仓、不改窗口。难看的结果也是结果,它告诉你算法在哪里不灵,这比一个好看的假结果值钱得多。
DID:把”大盘的变化”从”算法的变化”里剔掉
评估用的方法叫双重差分,公式一句话:
DID = (上线组上线后 − 上线组上线前) − (对照组上线后 − 对照组上线前)
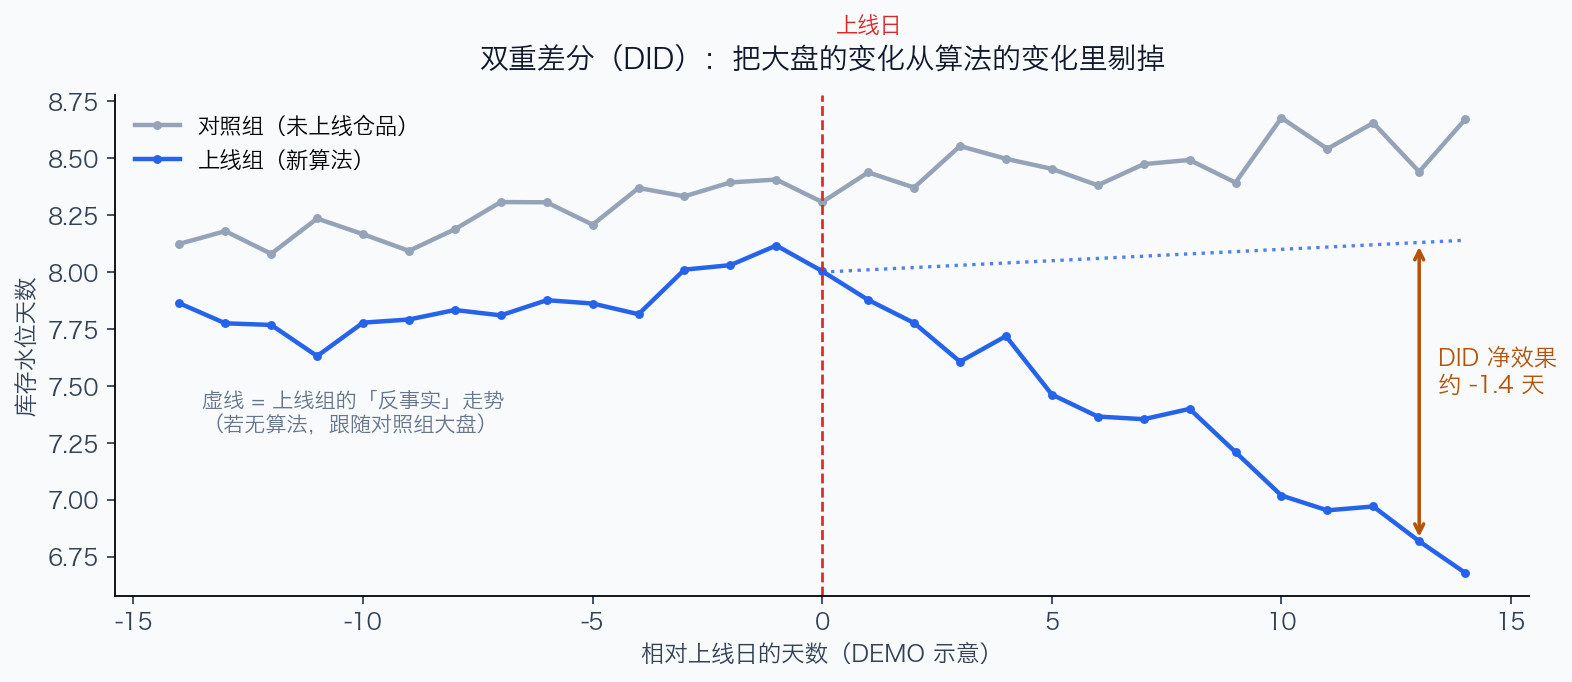
上线前后一比,会混进大盘自身的变化:季节、促销、消费回暖。对照组经历了同样的大盘,把对照组的前后变化减掉,剩下的才是算法净效果。指标盯三个:库存水位天数、期末库存件数、有效缺货率。
我们的早期监测里就出过一个典型情况:上线后两组缺货率都降到了 0。如果只看上线组,可以宣布算法消灭了缺货;看了对照组才知道,那周大盘本来就好。这就是对照组存在的意义,它不生产结论,它防止你生产假结论。
混杂因素:设计进去的变量,而不是事后的借口
实验跑起来,最大的敌人是混杂。我们踩过三个,现在把它们列为标准检查项:
上线前的在途订单。 老算法在下线前几天还批出去一批采购单,这些货在上线后才到。库存涨了,这算新算法的锅吗?不算,但库存曲线上长得就像。
对照组的到货节奏。 上线组和对照组的供应商不一样、到货日不一样,恰好对照组这几天没到货,库存自然低,显得上线组”涨了”。
人工超建议采购。 计划员没按算法建议下单,自己加了量。库存涨了,算法不该背这个锅,也不该贪这个功。
以前我们是在复盘会上用这三条解释”为什么数据看起来不对”,后来想通了:解释永远是被动挨打。正确姿势是把这三类因素做成数据里的显式标记,上线前在途量、每日到货、超建议采购标记,全部落表,分析时直接过滤或分层。混杂因素要设计在实验里,不能解释在复盘里。
结果分级:诚实是一种设计
最后一条经验关于怎么汇报。我们把所有结论分成三级:已验证(样本和窗口足够)、早期观察(方向性,仅供参考)、待确认(数据不全或混杂未排除)。早期监测只跑了 4 天时,报告上的每个数字后面都挂着”早期观察”,并且写明:库存水位相对 +0.35 天,缺货侧无恶化证据,样本覆盖率 89%,个别仓缺对照快照待补。
这样写报告在气势上是吃亏的,没有”显著提升”四个大字。但它换来的是长期信用:当有一天你写上”已验证”三个字,全公司都知道那是真的。
这套东西(找对照、冻结、DID、混杂清单、结果分级)没有一条是库存算法特有的。今天 AI 产品满天飞,每个都说自己效果好,我的问题是:你的对照组是谁?冻结了吗?混杂剔了吗?答不上这三个问题的”效果显著”,我一般默认为还没有证伪而已。
下一篇换个应景的话题:节假日。中秋国庆春节,安全库存该什么时候加、什么时候撤,这件事我们从纯经验做成了一套框架。
附录:对标 + DID + 混杂因素速查表
对标匹配规则(按优先级):① 候选仓必须销售相同商品,且整体排除全部上线仓;② 同省候选取近 90 天出库件数最接近者,件数差相同取地理距离更近者;③ 无同省候选则异省回退,取经纬度最近者;④ 全局无候选标记”无自动对标”。冻结纪律:对标关系落表 + 快照存档,评估期间不因短期结果重选对标、不改窗口。
指标与公式
库存水位(天) = 期末库存 ÷ 预测日均销
有效缺货率     = 有效缺货日数 ÷ 有效日数
DID           = (上线组后 − 上线组前) − (对照组后 − 对照组前)
解读纪律:两组指标同向同幅变化 = 大盘效应,不可归因算法;窗口过短只作方向性观察。
三类混杂因素(设计为显式变量)
| 混杂 | 机制 | 处理 |
|---|---|---|
| 上线前在途订单 | 老算法末批采购在上线后到货 | 上线前在途量落表,分析时标记 |
| 对照组到货节奏未匹配 | 对照组恰逢无到货日,库存天然偏低 | 每日到货量落表,按到货节奏分层 |
| 人工超建议采购 | 计划员未按建议下单 | 超建议采购标记,单独剔除分析 |
结果三级分类:已验证(样本窗口足够、混杂已排除)/ 早期观察(方向性参考,禁止作最终结论)/ 待确认(数据不全,补齐前不进成对样本)。
供应链实战系列 · 第 10 篇 · 卷四「库存策略篇」| 上篇:算法全切翻车记 | 下篇:节假日怎么办 文中数字均为 DEMO 示意,非真实业务数据。