上一篇讲了分布适配那套更聪明的算法。这一篇讲它第一次上生产的样子。
回测的时候一切都很美。新算法在数百个仓品(DEMO 量级)上跑了一个月的历史数据,库存降了 109 万件,周转从 6.7 天压到 5.5 天。评审会上所有人都在看这两行数字,方案顺利通过,全量切换。
一周后,缺货率从 1.96% 冲到了 8.05%。(以上都是脱敏后的 DEMO 数字,但故事是真的。)
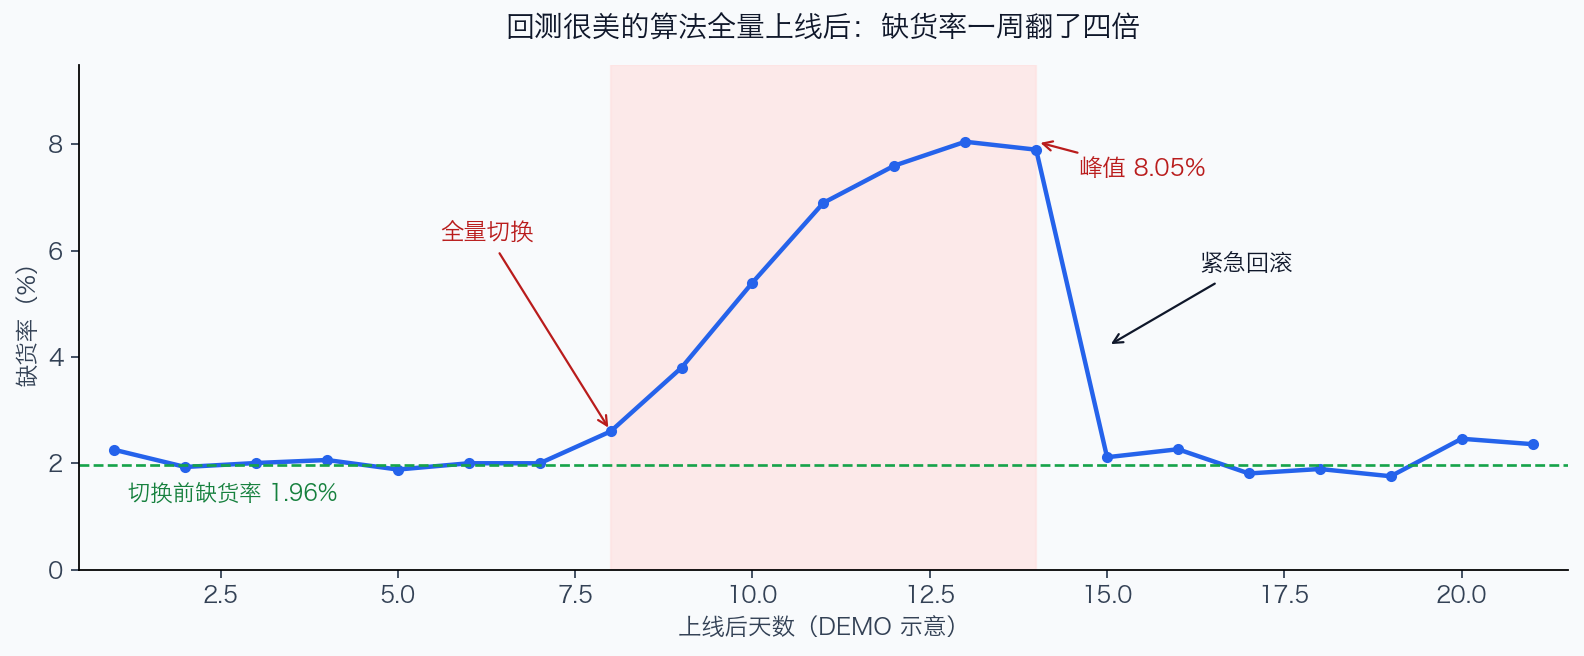
紧急回滚,逐仓品对账。根因挖出来的时候,我觉得这个教训值得写下来给所有做算法上线的人。
根因:算法在 3 天以下的区域是另一套物理
把翻车的 SKU 按”算法算出来的安全库存天数”排序,规律刺眼:算法 SS 低于 3 天日均销的 SKU 占了翻车样本的一半,这批 SKU 缺货率 14.4%;而人工管的同类商品,缺货率 2.9%。
为什么 3 天是个坎?因为安全库存公式假设的是一个理想世界:需求平滑、到货准时、下单立刻生效。真实世界里,供应商接单要确认、物流有截单时间、仓库收货要排队,一张订单从建议到上架,固定就要吃掉两三天。算法说”你只需要 1.5 天的缓冲”,它没有算进去的是,物理世界的反应速度本身就要 3 天。在反应时间以下,公式算出来的不是安全库存,是裸奔。
人工计划员从来不写公式,但他们的手感里带着这条常识,所以人工的水位很少低于 3 天。我们笑人工拍脑袋,人工笑我们不懂仓库。
修歪的一次:只卡下限,算法变成人工的复印机
第一次修复很自然:给算法加个下限,SS 不得低于 3 天日均销。缺货率立刻回到人工水平,皆大欢喜——直到有人多看了一眼库存:降幅归零了。
道理不难想。翻车的 SKU 恰恰是低水位 SKU,卡了下限之后它们全部被抬回人工水位;而高水位 SKU 的库存本来就没问题。两头一抵,算法和人工的结果几乎一样。我们造了一台昂贵的机器,功能是复印人工。
这次修歪比翻车本身更让我警惕:只看一个指标做修复,很容易把算法修成”人工的近似”,安全是安全了,价值也没了。
爬出来的路:上下限都卡,再用”双改善”筛一遍
最后的方案长这样。下限防裸奔:算法 SS 不得低于 3 天日均销。上限防空转:算法 SS 不得高于 (BP + VLT) 覆盖的日均销,超出说明算法在让你囤超过一个补货周期的货,逻辑上就不对。
卡完限还不算完,再加一道业务筛选:切换按仓 × 供应商粒度做,一个组合必须同时满足”缺货 SKU 数不上升”和”期初库存下降”才允许切换。两道条件缺一不可,因为只降库存的可能在偷缺货,只降缺货的可能在堆库存。
最终筛出一百多个仓 × 供应商组合(DEMO 化):缺货 SKU 数降了 31%,期初库存降了 6.6%,入选组合全部双改善。和最初”全量切换”的方案比,覆盖面积小了很多,但每一寸都是实的。
三件事
第一,回测的收益和上线的风险是两套账。 回测里库存降得最猛的 SKU,往往就是水位被压得最狠、离物理约束最近的 SKU。收益最大的地方,恰恰离悬崖最近。看回测报告,先按”激进程度”给 SKU 分层,最激进的那层单独审。
第二,约束层(guardrail)要设计在算法外面,不是改在算法里面。 上下限卡限没有动公式本身,它是在算法输出之后、执行之前加的一道闸门。这个结构后来救了我们很多次:算法可以随便迭代,闸门不变。
第三,切换的批准权交给”双改善”这样的业务结果,不交给统计显著性。 入选的组合不是回测分最高的,是回测里库存和缺货两头都站得住的。上线策略这个决定,最终要用业务的语言来做。
这三件事,放在今天 AI Agent 大面积上岗的背景下,我觉得只会更值钱。模型会越来越强,强到让人想跳过约束层直接信任它。翻车记录的价值就在于提醒你:裸奔的代价从来不写在模型的精度报告里。
但故事还没完。这些组合在回测里双改善,上了线就真的改善吗?回测说行的事,凭什么相信线上也行?下一篇讲我们怎么设计实验来回答这个问题,那是整套方法里我最得意的一篇。
附录:卡限规则与双改善筛选速查表
翻车根因链
裸算法全切
  → 算法 SS < 3 天日均销的 SKU 大量存在
  → 低于物理反应时间(接单确认 + 截单 + 物流 + 收货上架 ≈ 2~3 天)
  → 这批 SKU 缺货率 14.4%(人工同类 2.9%)
  → 全盘缺货率 1.96% → 8.05%
卡限规则(闸门在算法外)
下限:算法 SS ≥ 3 × 预测日均销            (防裸奔)
上限:算法 SS ≤ (BP + VLT) × 预测日均销   (防超囤一个补货周期)
只卡下限 → 低水位 SKU 全被抬回人工水位,库存降幅归零,算法退化为”人工复印机”。卡限不改公式本身,是输出后、执行前的独立闸门;算法可自由迭代,闸门保持稳定。
双改善筛选(切换批准权):粒度为仓 × 供应商,充要条件是”缺货 SKU 数不上升 且 期初库存下降”。单条件通过的组合不切换:只降库存可能在偷缺货,只降缺货可能在堆库存。
上线检查清单:① 回测按”激进程度”分层,SS 压缩最狠的 SKU 单独审;② 新旧版本回测产物先逐格 diff 再下结论;③ 灰度按仓 × 供应商粒度推进,不整仓切;④ 上线后按第 10 篇的对标方法持续监测,不因短期波动回改规则。
供应链实战系列 · 第 09 篇 · 卷四「库存策略篇」| 上篇:80% 的 SKU 不服从正态分布 | 下篇:库存算法上线怎么做 A/B 文中数字均为 DEMO 示意,非真实业务数据。