大促前两周,业务老大拍板:下周三全仓总量预期 340 万到 360 万之间,这是他从去年同期的经验里估出来的。同一天,模型输出的数字是 392 万。
差了近 10%。接下来怎么办?我在评审会上听过三种答案,每一种听起来都很有道理,每一种都是错的。
三个直觉做法,三个坑
做法一:乘个系数缩回去。 392 万乘 0.89,变成 349 万,落进区间,皆大欢喜。问题在于业务的 340~360 本身就是估出来的,自带几个点的噪声,乘系数等于把这个噪声放大后写进每一条预测曲线。更麻烦的是,同一个系数压下来,SKU 结构、周内形状全被拧了一遍:总量”对了”,结构”坏了”,下游补货拿到的是一条看似正常、实则变形的曲线。
做法二:解一组权重,让几个模型的组合精确命中区间中位数。 这是最危险的一个。第一,区间中位数是业务拍的估计值,让权重去精确命中它,等于让算法把锚点的噪声当真理学进去;第二,10 个模型凑 1 个目标值,权重解有无穷多组,今天 (0.6, 0.4, 0),明天锚点微调就变成 (0, 0.3, 0.7),下游看到的是毫无意义的乱跳;第三,未来 14 天逐日都要命中,一套权重对 14 个约束,数学上根本就无解。
做法三:别折腾了,每天直接用历史准确率最高的模型。 上一篇说过,模型池里准确率差距不到 1 个点时,排名基本是噪声。每天按噪声切换,生效模型频繁跳动,下游补货看到的全是抖动,没有收益。
正确的位置:当筛子,不当靶子
这三条路有一个共同的错误:把业务拍的数当成了”目标”,让系统想方设法去命中它。
我们的做法是把这句话反过来:锚点只能当约束用,不能当目标用。 它只回答一个问题——这个模型可不可用,它不修改任何数字。
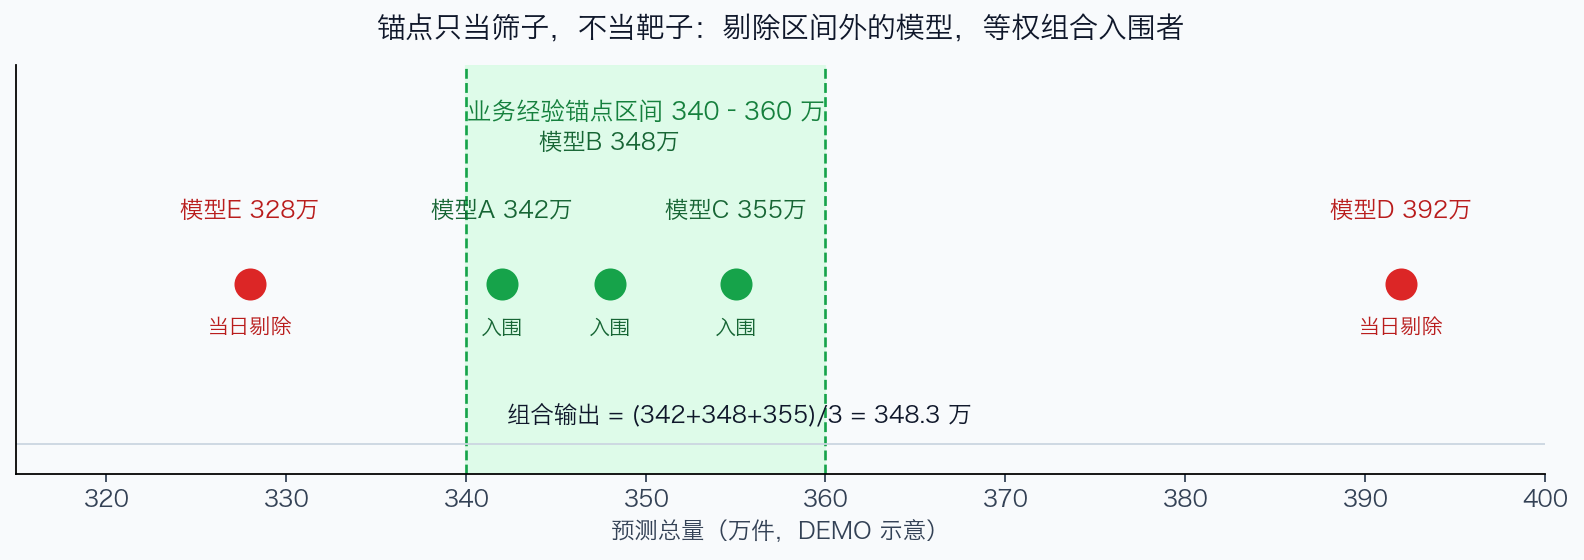
落到机制上是一条流水线:
- 业务经验变成区间。不拍点,拍区间,因为业务脑子里的经验天然就是个分布:“过去的周三,九成落在 330 万到 360 万。“让人拍一个精确值,是人为制造不存在的精度。
- 准入。准确率过线(比如 68%)的模型才有资格进池,这条线和团队现行考核一致,不新造标准。
- 修剪。预测落在区间外的模型,当天剔除出候选。注意,是剔除,不是修正。
- 组合。入围的模型等权平均。三个模型给 342、348、355,输出就是 348.3。为什么不选得分最高的那一个?因为只要各模型的误差不完全相关,平均之后的误差方差必然低于任何一个单模型,这是 1969 年就被证明的结论。等权平均听着朴素,几十年的文献里它稳定打败各种精巧的加权方法,花哨权重赢它的幅度,通常还不够补偿权重估计本身的误差。
- 防抖。新候选的得分要超过现任一定幅度才切换,避免追着噪声天天换模型。
- 兜底。如果所有模型都落在区间外,不自动纠正,取离区间最近的那个保生产,同时告警,把判断权交还给人。全体出区间是强信号:要么模型池集体失效,要么锚点拍错了,这两种情况都不该由机器自作主张。
还有一条容易被挑战的规定:大促、极端天气这类日子,机制整体暂停,人工直定,当天的数据单独标记,不进区间样本也不进准确率评估。因为这些日子历史分布和模型评估同时失效,机制硬上只会制造一种”伪精确的干预”。
这套思路和今天的 AI 是同一个道理
组合预测不是什么新概念,但这两年它在 AI 圈重新火了一遍:混合专家模型按输入路由到不同子网络,多模型系统按场景选择不同的 LLM,思想内核是一样的——不赌单一模型,让误差互相对冲。
更值得说的是”经验注入”这件事。现在人人都想把自己的业务 know-how 灌进 AI 系统,主流做法是微调、是奖励函数、是提示词里的硬要求。这些做法本质上都是把经验当”目标”喂进去,模型会想方设法迎合它,包括用你看不出来的方式凑数。我们的实践给出了另一个答案:让经验去定义边界,而不是定义终点。 约束错了,代价是候选集变小,有告警兜底;目标错了,错误直接写进输出,而且看起来一切正常。这个区别,在做 Agent 护栏、做模型安全边界的人看来应该很眼熟,是同一个道理。
机制上线那天,业务老大问:那我拍的数到底有什么用?我说:你拍的还是全公司最重要的数,只不过它现在的角色是裁判,不是运动员。
附录:动态模型选择机制速查表
设计红线:业务锚点区间只作约束(constraint),不作目标(target)。作约束,锚点噪声只影响筛选边界,错了有告警兜底;作目标,噪声直接写进输出,且无告警可发现。
机制流水线
M1 锚点区间构造 → M2 准入 → M3 区间修剪 → M4 组合输出 → M5 防抖 → M6 兜底告警
- M1:历史同期用相对值口径——当日销量 ÷ 前后 4 周均值,算比率的经验分位数区间,再乘回当前基准。大促/节假日/极端天气/缺货日样本剔除。绝对值口径会把增长趋势错算成波动。
- M2:准入线 = 准确率 ≥ 68%(与团队现行考核一致,可参化)。无人入围时逐 1pp 下调并告警,不静默取最高。
- M3:预测值落在锚点区间外 → 当日剔除该模型。
- M4:入围模型等权平均(可升级 trimmed mean)。理论依据:误差不完全相关时组合方差必低于任一成分模型(Bates & Granger, 1969)。
- M5:新候选得分超现任一定幅度才切换;确认值微调小于阈值不重算。
- M6:全体出区间 → 取距区间最近模型保生产 + 告警,人工当天可直定。
暂停机制:大促、节假日、极端天气日,机制停用 → 业务+算法人工直定 → 当日数据单独标记,不进区间样本与准确率评估。
供应链实战系列 · 第 02 篇 · 卷一「预测篇」| 上篇:如何做一个能生产的预测 | 下篇:如何做补货 文中数字均为 DEMO 示意,非真实业务数据。